
A07 · 第 5 章 · 第三编 Transformer 与综合复习
编码器、解码器与 Transformer 架构
由多头注意力、逐位置前馈层、残差和归一化组装编码器与因果解码器,区分 pre/post norm 与 cross-attention,解释教师强制训练、KV 缓存解码、参数量、平方注意力成本和长序列边界。
本章目标
- 写出编码器、decoder-only与encoder–decoder块的子层、形状和mask。
- 比较pre-norm与post-norm的残差公式、最终归一化和梯度路径。
- 解释逐位置FFN如何扩展通道并共享于所有位置。
- 区分教师强制的整段并行训练和自回归逐token生成,并正确维护KV缓存。
- 估算每块参数、注意力与FFN计算和缓存内存,限定长序列能力。
本页目录
Transformer 块的维度
输入 token 表示通常为 。多头注意力和逐位置前馈网络都把最后输出映射回 ,使残差相加形状闭合。位置表示在进入块前或注意力内部注入;padding 与因果关系由 mask 控制。每一层可有不同参数,但同一层的参数跨全部位置共享。
一个完整实现还包含 token 嵌入、可能的输出词表投影、dropout、最终归一化和任务头。词嵌入与输出投影可共享,也可独立;共享会改变参数量和尺度约束。只数注意力层会漏掉常占大量参数的前馈层与词表矩阵。
编码器的双向上下文
编码器自注意力的 Q、K、V 都来自当前序列,通常只用 padding mask,不用因果 mask。每个有效位置可读取序列中所有有效键。注意力输出经过残差后,再由逐位置 FFN 处理。FFN 可写为
其中 ,。它对每个位置独立应用同一参数,不在位置间混合;位置混合由注意力完成,通道内非线性变换由 FFN 完成。
设 。输入与层归一化输出均为 ;Q/K/V 重排为 ,注意力分数为 ,拼接和输出投影后回到 ,可与残差相加。
FFN 第一线性层得到 ,激活不改形状,第二层回到 ,再做残差相加。padding mask 从 广播到注意力键轴,FFN 不需要注意力 mask,但填充查询在损失和后续输出处仍要屏蔽。
编码器适合需要整段输入的表示、分类和条件生成源端。若任务要求在线流式处理,双向注意力会读取尚未到达的未来,必须改成块状、因果或有限右上下文,而不能只在部署时截断。
Pre-Norm 与 Post-Norm
pre-norm 子层可写为
通常在全部块后再有一次最终 LayerNorm。残差主路直接包含恒等映射,深层梯度有一条不经过子层和归一化的路径。post-norm 则写为
输出每次相加后立即归一,但残差到更早层的梯度要经过归一化 Jacobian。二者不是加载权重时可随意互换的代码顺序,初始化、训练稳定性和最终层归一化都不同。
把一个子层局部导数近似为 。忽略归一化时残差 的导数为 ,含恒等项。pre-norm 的精确导数为 ,仍保留直接的一。
post-norm 导数为 ,整条路径都乘归一化 Jacobian。真实 LayerNorm 是跨特征耦合的矩阵,不能用单个标量完整描述;该例只展示恒等路径差异。实际应记录逐层VJP和激活尺度,而不是据此宣称某形式总更优。
残差 dropout 通常作用于子层输出再相加,位置改变也会改变期望和缓存一致性。归一化的 epsilon、仿射参数和轴要与权重来源匹配。
因果解码器
decoder-only 架构每块包含因果自注意力和 FFN。训练输入为目标序列右移后的 token,位置 预测下一个 token;下三角 mask 阻止读取未来真实 token,因此整段仍可并行算 logits。padding mask 与因果 mask 共同作用。
教师强制训练条件是正确历史 token,而自由生成会把模型自己选出的 token 反馈为下一步输入,产生分布差异。交叉熵下降不保证长生成无误差累积;评估既要看教师强制损失,也要按真实解码规则检查序列级结果。
目标 token 为 。训练输入可取前三个 ,监督目标取后三个 。输入位置一只看 BOS 并预测 A;位置二看 BOS、A 并预测 B;位置三看前三项并预测 EOS。
三个位置 logits 可一次矩阵计算,但因果 mask 确保位置一不会读取 A 或 B 的输入表示。若目标未正确右移,模型可能直接看到要预测 token,训练损失异常低。测试可改变未来 token,确认早期 logits 不变。
编码器解码器与交叉注意力
编码器先产生源表示 。解码器每块通常依次执行目标因果自注意力、cross-attention 和 FFN。cross-attention 的 Q 来自当前解码表示,K/V 来自编码器输出,因此分数形状为 。
源 padding mask 遮 cross-attention 的无效键,目标因果 mask 只作用于解码自注意力。cross-attention 不应按目标位置再遮掉“未来源 token”,因为完整源序列在条件生成时已经可用。若是同步流式任务,源可见范围需另行定义。
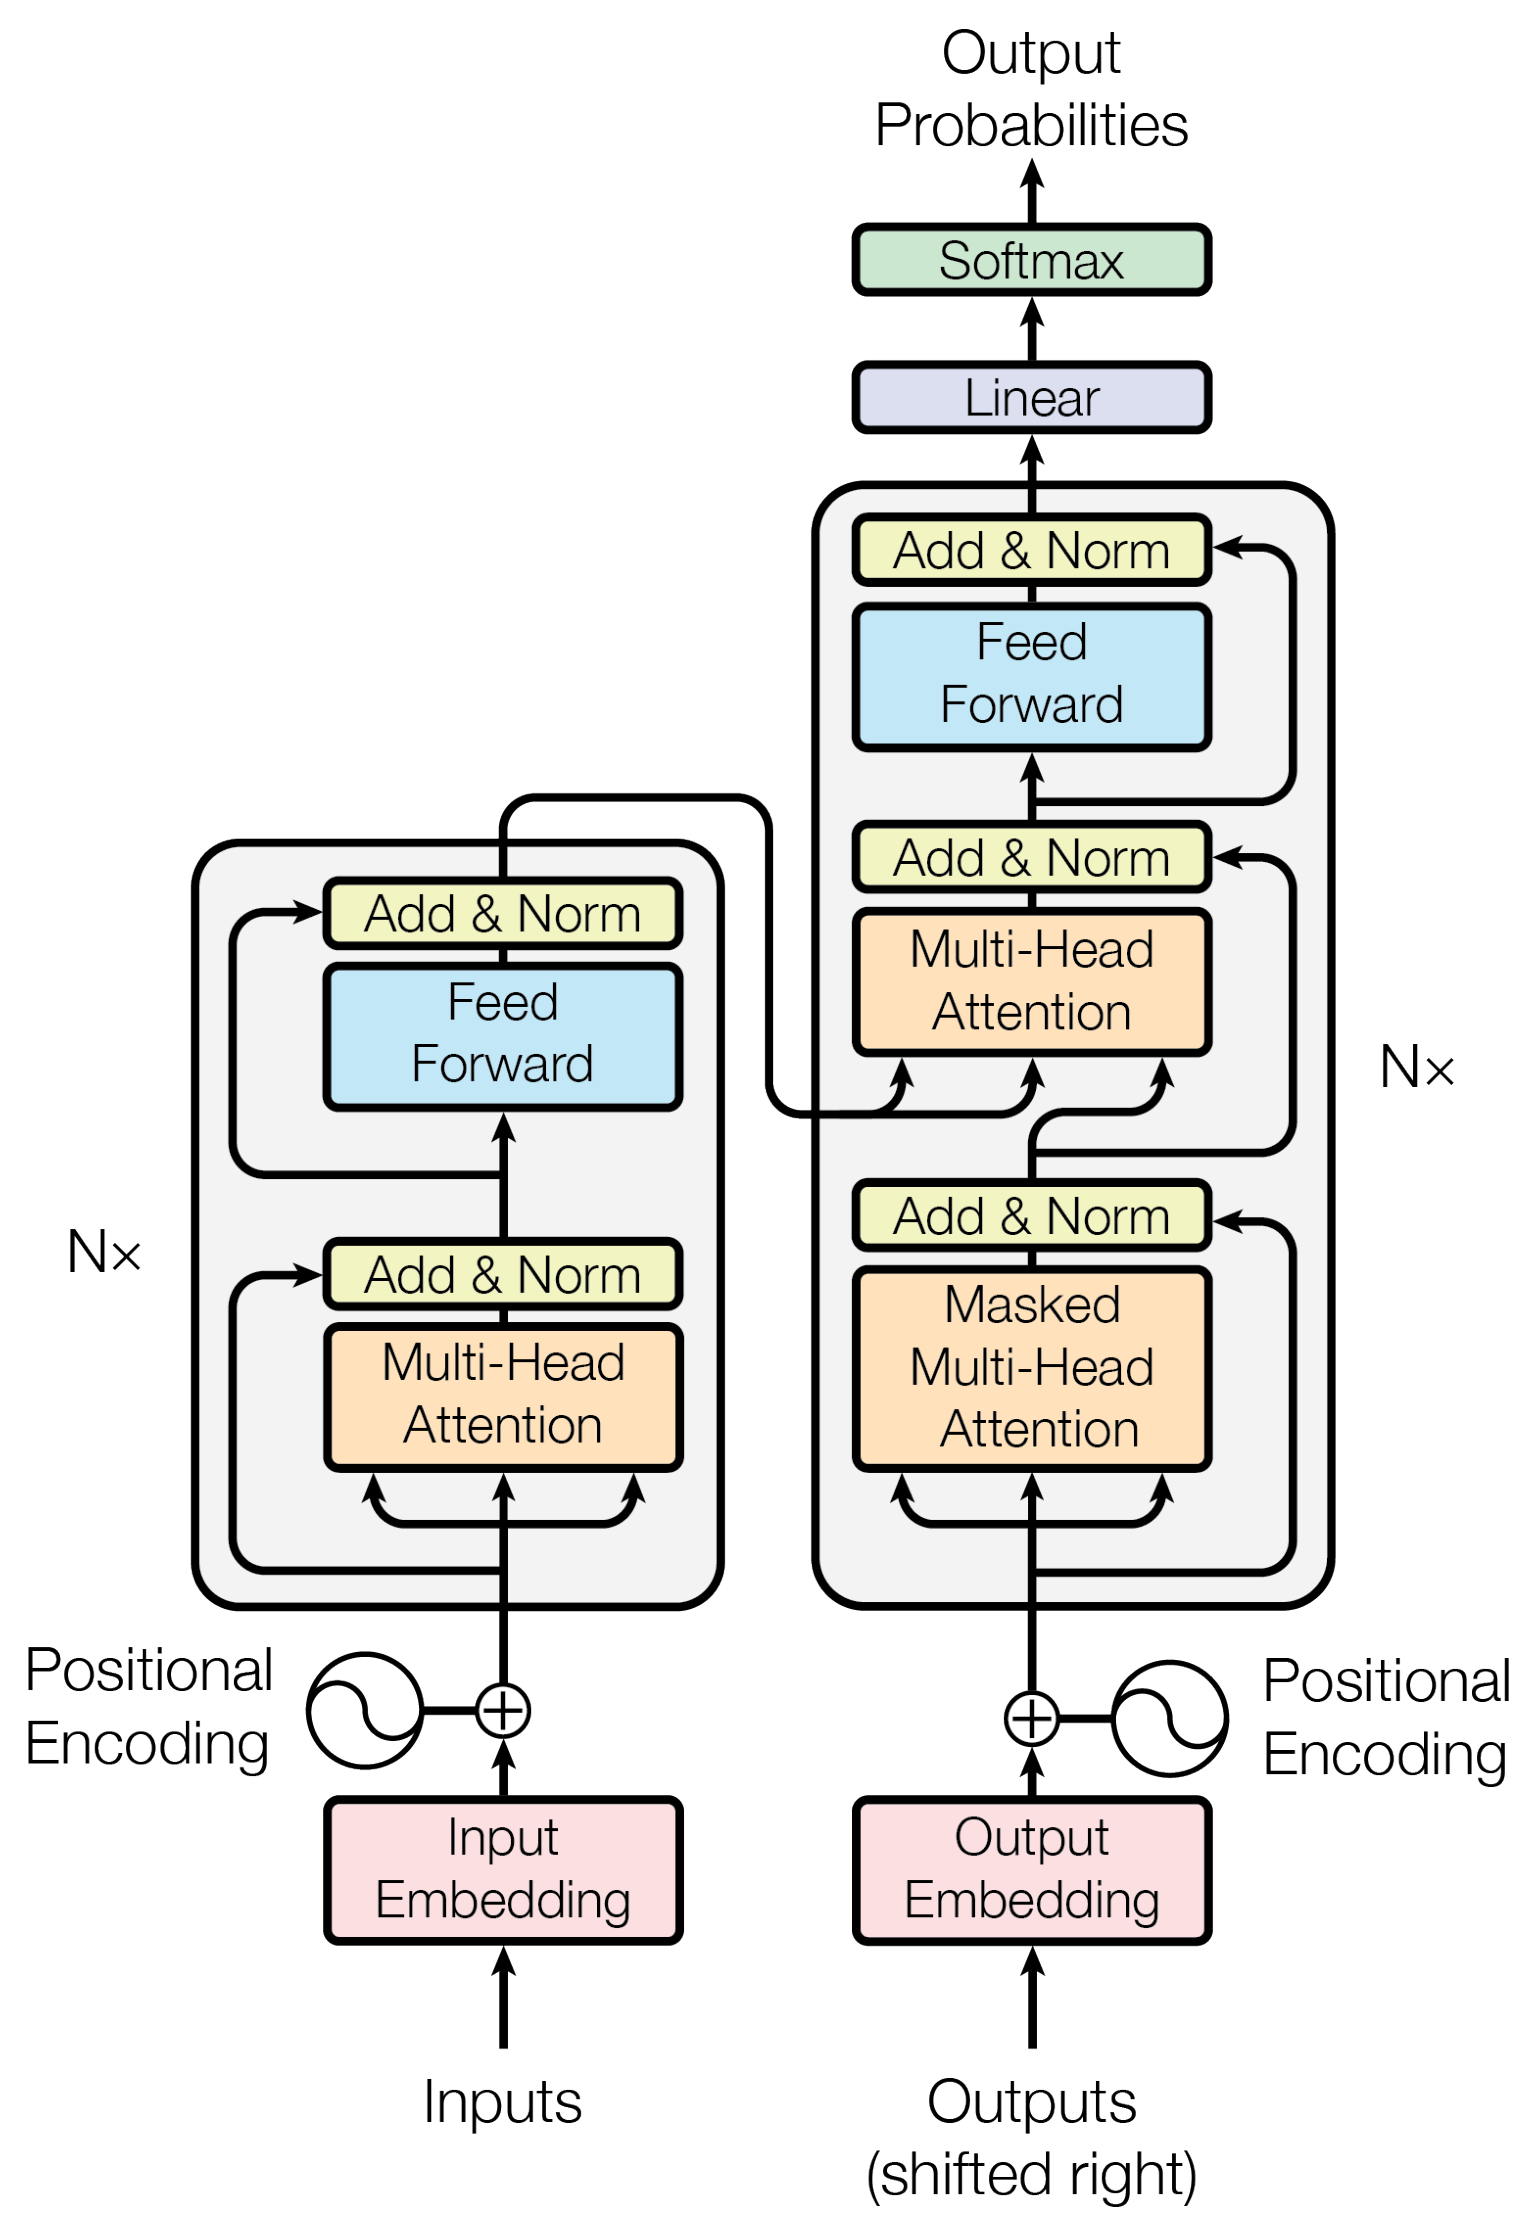
编码器输出只计算一次;生成时各解码层的cross-attention K/V也可由源表示预投影并缓存。不同 beam 可共享只读源缓存,但自身解码 K/V 与 token 历史不同,需要按 beam 重排。
批量二,源长度七,当前目标长度五,模型宽十二,三头、每头四维。cross Q 为 ,K/V 为 ,分数为 ,输出拼接后为 。
源有效长度为七和四时,源 mask 形状可为 ,第二样本最后三列对全部目标查询遮蔽。目标因果 mask 不广播到这张五乘七矩阵;它只用于五乘五的解码自注意力。
投影层与 FFN 的参数量
设标准自注意力总头宽等于 。Q/K/V和输出投影忽略偏置约有 个参数;FFN两矩阵约有 。LayerNorm每次约有 个仿射参数。encoder–decoder的解码块多一个cross-attention,因而多一组约 投影。
取 。自注意力四个主矩阵约有 个权重;FFN有 个权重。忽略偏置和归一化,一个编码块合计约三百一十五万主权重。
头数从八改十六但总宽仍五百一十二时,四个投影矩阵形状不变,主参数量不变;每头维从六十四降到三十二。若词表很大,输入嵌入和输出投影还可能超过单块参数,是否共享必须计入总表。
参数量不随序列长度变,激活与计算却随长度变化。只比较模型文件大小不能预测长上下文显存。
注意力的序列长度复杂度
自注意力 QK 与 AV 的核心计算约为 ,分数或概率显式存储约为 。FFN成本约为 ,对长度线性。短序列和大 时FFN可主导,长序列时平方注意力逐渐成为瓶颈。
高效精确内核可以分块计算 softmax,避免把完整 概率矩阵长期写入显存,降低中间内存和访存,但精确全连接注意力的点积数量仍是平方级。局部、稀疏、低秩或核化注意力减少连接或作近似,会改变可见关系与误差,需要任务验证。
cross-attention成本约 ;源目标长度不等时不应简写为同一个平方。padding到整批最大长度会浪费计算,长度分桶可减少浪费但改变批组成。
KV 缓存的计算成本
自回归生成第 个新token时,过去层表示在因果模型中不会因未来token改变。每层可缓存过去 K/V,只为新token计算一个Q和新的K/V,再让Q读取长度缓存。这样避免每一步重算全部前缀投影与隐藏状态。
若层数 、头数 、每头维 、缓存长度 ,K与V缓存标量数约为 ,还要乘数据类型字节数和beam数。每个新token注意力计算仍随当前长度线性,一段长度N生成的累计注意工作仍近似平方。缓存以空间换重复计算。
缓存必须记录位置、padding或滑窗偏移,并随beam筛选重排。模型训练模式的dropout应关闭;不同批请求合并时,每条序列有效长度不同,不能让新查询读取其他请求或未初始化槽位。
上下文长度与远程信息利用
模型“支持”长度可能仅指位置表示、mask和内核不报错。可靠使用还要求训练或适配覆盖相应距离,注意力能找到远处证据,解码质量与校准保持,延迟和缓存符合预算。位置插值、旋转频率缩放、滑动窗口和稀疏连接都会改变模型,应单独评估。
长序列还会稀释固定头数的注意分辨率,重复模式增加检索歧义,重要信息可能被截断或落在训练罕见位置。按依赖距离、输入长度和证据位置分组测试,比只报平均损失更能揭示边界。上下文中存在文本不代表模型必然使用它。
嵌入、输出头与填充
token嵌入把整数索引映射为 维向量,输出头把隐藏状态映射到词表 logits。若二者共享权重,输出矩阵是嵌入矩阵的转置视图,参数量减少,但输入输出词表和尺度必须兼容。某些实现把嵌入乘 后再加位置表示,另一些不乘;迁移权重时这一常数会改变初始相对尺度。
padding键被mask后,padding查询仍可能经过残差、偏置和FFN得到非零表示。只要它们始终不被有效查询读取且不进入损失,数学任务可保持;但若后续池化或缓存没有继续遮蔽,非零padding会泄漏。每层mask、最终损失和序列汇聚应使用同一有效长度合同。
输出交叉熵常忽略padding目标并按有效token数求平均。若按批内总槽位平均,长短序列比例会改变梯度;若先逐序列平均再平均,每条序列权重相同。两种目标不同,应明确选择并在分布式归约中保持。
训练激活的内存占用
反向需要保存各层输入、Q/K/V、softmax所需统计、FFN中间激活和dropout状态。即使高效注意力不保存完整概率, 的FFN激活仍可能很大。梯度检查点可按若干块重算前向,以额外计算换峰值内存;随机状态与mask必须重现。
低精度计算时,softmax归约、LayerNorm统计和大词表损失常需更高精度累积。非有限值应定位到具体子层,不能只靠全局梯度裁剪掩盖。长序列改变归约项数,训练稳定设置也应按长度分组核验。
架构核验顺序
先用不同的 检查每个子层形状和mask;再做未来token不影响过去logit的因果测试;训练与逐步无缓存解码在同一前缀上应给一致下一个token logits;开启缓存后还应与无缓存一致。随后检查pre/post norm、dropout模式和位置索引。
最后分别记录注意力与FFN时间、峰值内存、缓存字节和每token延迟。数值一致只证明实现,任务能力仍需独立数据与真实解码协议评估。
练习
写出编码器块的形状不变量。
查看提示
查看解答
比较两种归一化公式。
查看提示
查看解答
说明cross-attention应使用哪些mask。
查看提示
查看解答
估算一个标准编码块主权重。
查看提示
查看解答
计算一组KV缓存元素数。
查看提示
查看解答
设计KV缓存的数值对照。
查看提示
查看解答
关系与资源
- 多头注意力与位置表示 提供投影、mask和位置机制。
- 归一化方法与尺度控制 解释pre/post norm状态。
- 序列损失、教师强制与解码 提供目标移位和生成规则。
- 注意力机制 提供加权信息汇聚基础。
- 循环网络、门控单元与状态传播 对比顺序状态与全局注意力。
- 长序列、效率与Transformer综合复习 综合架构选择和长上下文边界。
Attention Is All You Need
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, Illia Polosukhin · 2017 · Advances in Neural Information Processing Systems 30
打开官方来源Deep Learning
Ian Goodfellow, Yoshua Bengio, Aaron Courville · 2016 · MIT Press
打开官方来源《Attention Is All You Need》用于核对标准 Transformer 的多头注意力、残差、归一化、位置编码与编码器—解码器连接;《Deep Learning》用于核对序列概率、前馈网络、反向传播和优化基础。本章逐层标注张量形状与掩码轴,避免仅凭结构示意图推断实现正确。
CS224N: Natural Language Processing with Deep Learning
Diyi Yang, Tatsunori Hashimoto · 2025 · Stanford University
打开官方来源Stanford CS224N 的 Transformer 课件介绍自注意力、多头注意力与位置表示,并提供相关作业。