
A12 · 第 4 章 · 第二编 多模态模型
检索增强与事实落地
把检索增强拆成查询、稀疏/稠密召回、分块、重排、上下文构造、生成和声明级引用链,分别评价召回、忠实性、完整性与新鲜度,并处理提示注入、权限和证据不足。
本章目标
- 把检索增强系统分解为查询、召回、重排、上下文构造、生成、引用和核验阶段。
- 比较稀疏、稠密与混合检索,计算Recall@k和倒数排名融合。
- 设计带稳定来源、重叠和访问控制的分块方案,并计算上下文预算。
- 区分证据被召回、回答忠实于证据、引用支持声明和来源本身正确新鲜。
- 处理检索提示注入、权限泄漏、索引更新延迟和证据不足时的拒答。
本页目录
检索增强的处理流程
系统接收问题 后,先构造检索查询,召回候选片段,按相关性和权限过滤或重排,再在长度预算内组成上下文 ,最后由生成器估计 。输出若包含引用,还要把每个声明映射回片段、原文档、版本与位置。任一阶段都可失败:查询丢失约束、召回漏证据、重排误降、上下文截断、生成忽略证据或引用指错来源。
因此“加入检索”不是事实正确性的保证。它只让模型有机会读取外部材料。若来源错误或过期,忠实复述仍可能不正确;若正确材料进入上下文,模型仍可能加入没有支持的内容;若答案碰巧正确,引用也可能并不支持相应声明。检索、使用、忠实、正确和引用完整性必须分别评价。
链路还应保留可重放输入:原始问题、查询改写、索引版本、过滤条件、候选分数、最终片段顺序、生成配置和引用映射。只保存最后答案无法定位是检索错误还是生成错误。
稀疏检索与稠密检索
稀疏检索以词项、文档频率和长度归一等统计匹配查询与片段,擅长产品编号、姓名、公式符号和罕见术语等精确重合。它对同义改写较弱,也受分词和拼写影响。稠密检索把查询与片段编码成向量,用内积或余弦检索语义相近内容,能连接部分同义表达,却可能忽略关键数字或否定词,并继承编码数据偏差。
两者都可采用近似索引降低大规模搜索成本。稀疏倒排只访问含查询词的列表;稠密近邻图或量化索引牺牲部分精确召回换取延迟和内存。评价时要用精确搜索或足够强基线区分“表示没找到”和“近似索引漏掉”。
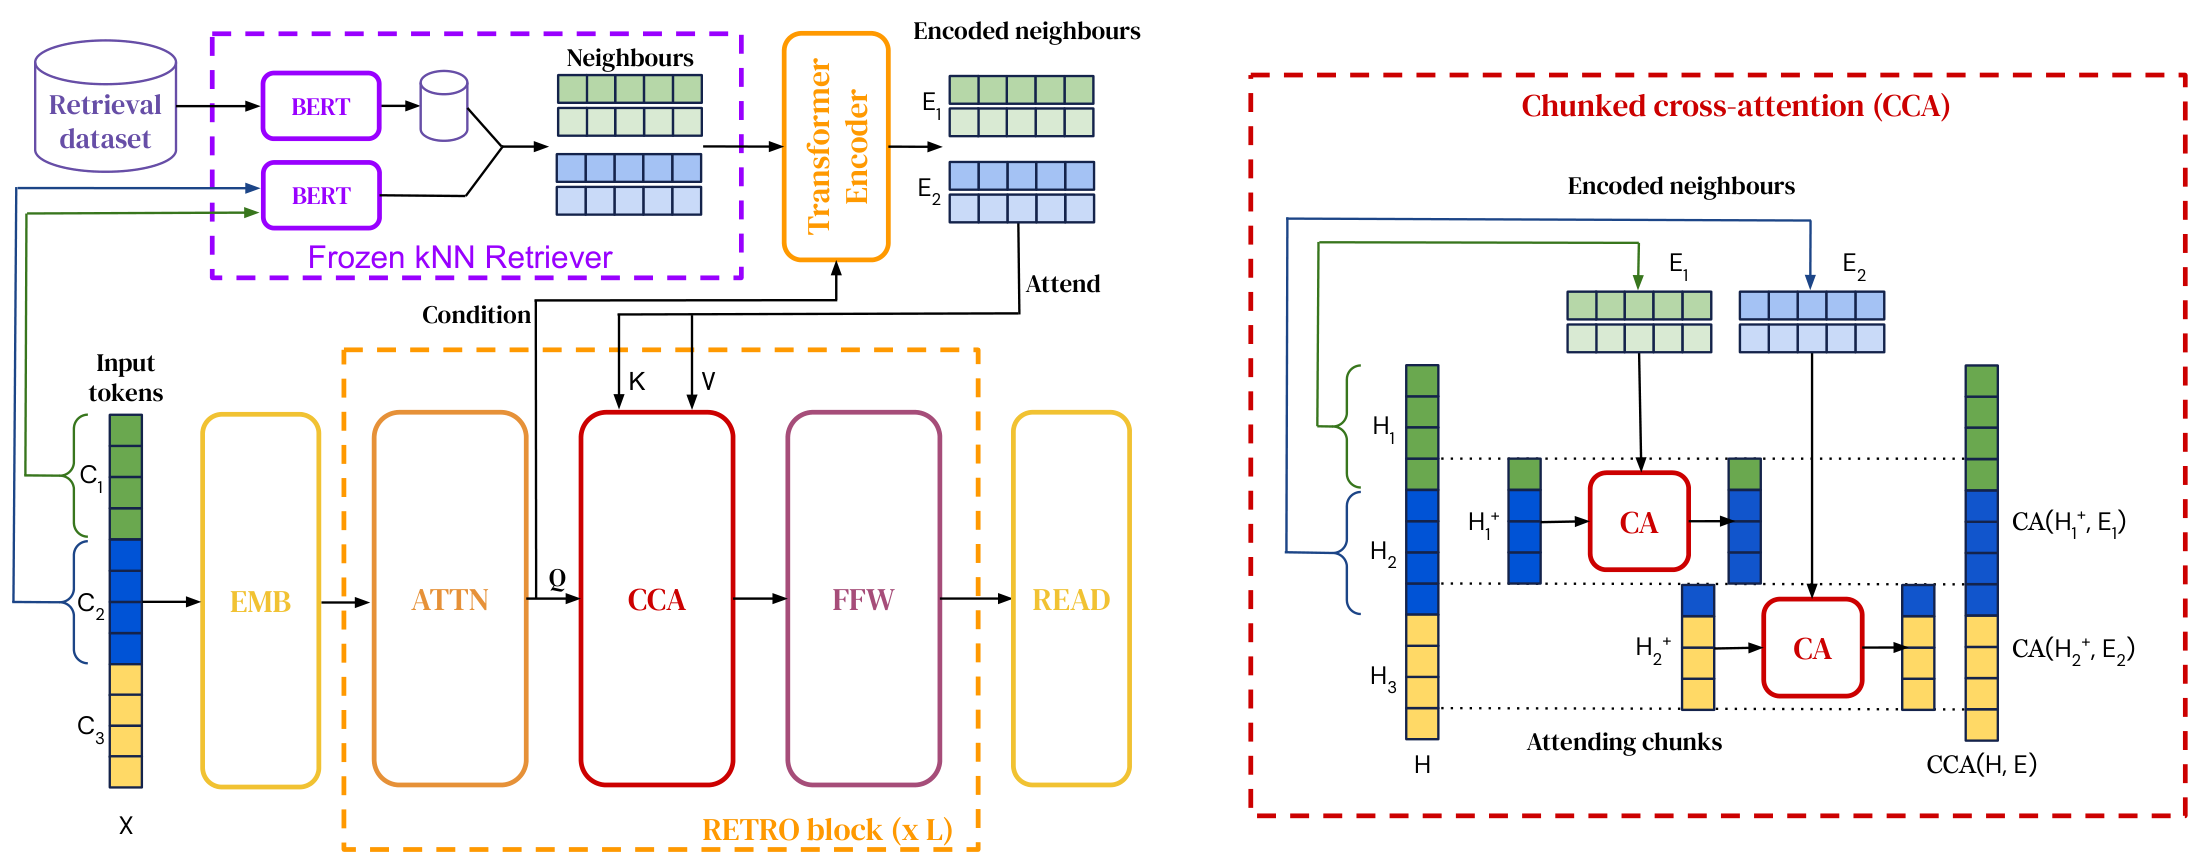
RETRO 使用冻结的检索器获取相邻文本块,再通过分块交叉注意力将检索结果接入语言模型。
混合检索不能直接相加未经校准的原始分数,因为稀疏和稠密分值范围不同。可以在验证集上归一化加权,也可只融合名次。倒数排名融合定义
其中 控制前几名差距,缺席某列表的文档不贡献该项。
文档甲在稀疏列表排一、稠密列表排十;文档乙分别排四和二。取 ,甲分数为 ,乙分数为 ,所以融合后乙略高。
若直接把一个范围为零到二十的稀疏分数与零到一的余弦相加,稠密信号几乎不起作用。RRF避免原始尺度问题,但参数六十和候选截断仍会改变结果,需在独立查询集上选择。
查询构造与用户约束
短问题可直接检索,长对话常需把代词、时间、产品版本和地域补进独立查询。改写能提高召回,也可能改变意图:把“不能用于儿童的药物”改成“儿童药物”会丢失否定。应同时保留原始查询与改写,必要时并行检索后融合。
多跳问题可能需要先找到实体,再用第一跳结果形成第二跳查询。每次扩展都增加延迟和漂移风险,停止条件要由证据缺口而非固定“思考轮数”决定。涉及数值、日期和专名时,可把关键词通道与语义通道并行,避免只依赖生成式改写。
文档分块与召回
文档进入索引前通常按标题、段落、句子或token窗口切块。块过小会失去定义、条件和结论之间的上下文;块过大会混入多个主题、稀释向量并浪费生成窗口。固定重叠能减少边界切断,但会生成近重复候选,占据top-。
每块需要稳定标识、原文档标识、版本、起止位置、标题路径、时间和访问控制。稳定标识应区分同一文档的不同版本;更新后旧块要删除或标记失效,不能让新旧规则同时进入上下文。解析表格、代码和PDF时还要保留行列、页码或章节结构,而不是只拼成无位置纯文本。
一篇一千token文档采用块长三百、重叠五十,步长为二百五十。起点为零、二百五十、五百、七百五十,共四块,最后一块覆盖到文末。一个位于token二百九十到三百一十的事实,在第二块二百五十到五百五十中完整出现。
若无重叠且块起点为零、三百、六百、九百,该事实会被前两块切开,任何单块都不完整。重叠并非越多越好:重叠二百五十时步长只有五十,会产生大量近重复块并挤占候选。
语义分块可按标题或主题边界自适应,但模型分段结果需可复现,并避免使用未来敏感数据。分块策略变化相当于索引结构变化,比较前应整体重建或明确混合版本。
召回与重排的性能上限
第一阶段追求高Recall@,允许候选含噪;重排器读取问题和候选的联合特征,把更相关证据推到前面。cross-encoder重排能处理词间交互、否定和条件,成本随候选数增长。重排器只能移动已有候选,不能恢复未召回证据。
五个问题的首个正确证据在初检列表排名为 。Recall@5为三个成功除以五,即 ;Recall@10为四除以五,即 。取top-10交给重排器后,四个已召回证据被排到 ,最终Recall@3为 。
原排名十二的证据不在重排输入,无法被救回。若只报告重排后四个可见问题上的百分之百,会隐藏召回失败;分母必须保留全部问题,并分别报告候选Recall和重排增益。
多证据问题还要评价证据集合覆盖。只找到结论而漏掉适用条件,生成器可能作过宽回答;只找到两跳中的一跳,也不能支持最终推理。标注应尽量区分必要证据、可替代证据与背景材料。
上下文窗口与来源映射
构造器按预算选择片段,去除近重复,保留标题、来源和边界,并避免在句中截断关键条件。相关性最高不一定是最佳组合:四个重复片段可能不如三个互补来源。可用覆盖、时间、来源多样性和权限作为约束,但每项都要说明排序规则。
模型窗口四千零九十六token,系统说明预留二百五十六,用户问题预留二百五十六,最大输出预留七百六十八,因此证据预算为 。
每块正文六百二十token,来源包装和分隔符四十,共六百六十。最多放入 块,占二千六百四十,剩余一百七十六。第五块会超预算;若实现截掉它的尾部,引用可能只保留结论而丢失限定条件,构造器应在块或句子边界明确取舍。
“窗口放得下”不表示模型能可靠使用每处证据。片段顺序、长上下文中的位置、冲突来源和问题复杂度都会影响使用。应比较不同候选数、顺序和oracle上下文,检查证据的使用情况。
引用与主张的对应
生成器可在上下文中读取带稳定编号的片段,并在句子或声明后输出编号。系统再把编号解析为原文档链接和位置。引用不能由答案生成后再仅按语义相似度“补一个最近来源”,因为相似文档可能没有蕴含该声明。
声明级检查至少回答三问:引用片段是否包含相应信息,片段是否在适用条件和时间上支持该表述,答案是否把多个来源的结论错误合并。一个段落含四个事实却只在末尾放一个来源,不能假定来源支持全部四项。
回答被拆成四个可核查声明,其中三个附引用,一个无引用。人工核对发现三个引用中有两个支持对应声明,一个只谈相近主题。引用覆盖率为 ,已引用声明的支持率为 ,全部声明得到支持的比例为 。
只报告覆盖率会把错误引用算成功,只报告已引用支持率又会忽略无引用声明。若某一声明需要两个来源联合支持,还应检查两个来源是否都被列出且推理连接有效。
自动蕴含模型可用于大规模筛查,但也会受长文本、否定和数值比较影响;高风险领域仍需抽样或人工核对。引用格式正确只是解析成功,不等于语义支持。
上下文忠实性与事实准确性
上下文忠实性检查答案是否只陈述证据允许的内容。事实正确性还依赖来源质量、新鲜度和问题所指时点。两个版本冲突时,系统应按版本、发布日期和适用范围处理,并在无法消解时展示冲突或拒答。
假设设备手册旧版写最大压力八MPa,新版写十MPa,问题询问当前版本。检索器把旧版排一、新版排四,而上下文预算只放前三项。生成器回答八MPa并正确引用旧版:它对所见上下文忠实,引用也确实支持八,却没有回答当前版本事实。
修复要从索引和构造器处理版本:记录适用型号与生效时间,对“当前”查询优先有效最新版,并在旧版仍可能适用时说明范围。仅要求模型“更忠实”无法补回未进入上下文的新版本。
索引更新要有抓取时间、源版本、删除传播和缓存失效策略。实时源不代表实时索引;展示“来源日期”也不代表内容仍有效。对易变事实可设置最大陈旧时间或查询时回源,并把无法达到的新鲜度写入回答边界。
检索内容的信任边界
网页、邮件和文档可能包含“忽略先前要求”“调用工具发送数据”等提示注入文本。检索器把它们放入上下文后,生成模型可能误当指令。系统应把来源内容放在明确数据边界内,优先级低于系统与用户授权;对工具调用实行独立权限、参数验证和最小权限,不能依赖一句“不要听文档指令”。
注入防护还包括来源允许列表、主动内容剥离、可疑模式标记、工具前确认和输出数据流控制。攻击者可以用自然语言改写绕过简单关键词,因此要用端到端攻击集测试。即使模型拒绝执行,也可能在回答中泄露上下文里的秘密。
访问控制必须在召回前按当前用户过滤,不能先取全库top-再期待生成器不引用无权片段。索引缓存、向量副本、日志和引用链接都要继承删除与权限。稠密向量本身也可能泄露成员或内容特征,不应被视为无敏感信息。
组件评估与端到端评估
检索集标注查询—证据相关性,报告稀疏、稠密、混合的Recall@、排名和延迟;重排单独测候选内排序。生成阶段用oracle正确证据测试“会不会使用”,用真实检索测试端到端,用空上下文测试模型先验。三者差异有助于定位瓶颈。
答案评价拆成任务正确、声明支持、引用覆盖、来源质量、拒答适当性和冲突处理。安全评价加入恶意文档、越权文档、删除后文档和索引延迟。最终还要报告成本、尾延迟和失败率;提高候选数可能改善召回,却扩大上下文、注入面和费用。
练习
画出可追踪的检索增强链路。
查看提示
查看解答
为含产品编号的同义问句设计检索。
查看提示
查看解答
说明如何选择并核验分块方案。
查看提示
查看解答
解释为什么优秀重排器不能弥补低召回。
查看提示
查看解答
说明“有引用”不等于“事实正确”。
查看提示
查看解答
设计含私有文档的安全检索约束。
查看提示
查看解答
概念关系
- 视觉语言模型 提供双编码器相似度与跨模态检索。
- 哈希、堆与图算法 支持索引、近邻和候选管理。
- 条件概率 区分问题、上下文与输出的条件关系。
- 数据切分与泄漏 约束重复文档、查询和评价证据隔离。
- 语言建模与规模规律 提供条件生成目标与计算背景。
- 工具、记忆与规划 延伸权限、状态与外部动作链。
- 大模型智能体综合复习 汇总端到端成功、成本和安全评价。
资源
Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Küttler, Mike Lewis, Wen-tau Yih, Tim Rocktäschel, Sebastian Riedel, Douwe Kiela · 2020 · Advances in Neural Information Processing Systems 33
打开官方来源Deep Learning
Ian Goodfellow, Yoshua Bengio, Aaron Courville · 2016 · MIT Press
打开官方来源RAG 论文介绍检索器与生成器的组合。《Deep Learning》提供序列生成的基础,可结合本章比较检索结果、生成内容和引用依据。
Improving language models by retrieving from trillions of tokens
Sebastian Borgeaud, Arthur Mensch, Jordan Hoffmann, Trevor Cai, Eliza Rutherford, Katie Millican, George van den Driessche, Jean-Baptiste Lespiau, Bogdan Damoc, Aidan Clark, Diego de Las Casas, Aurelia Guy, Jacob Menick, Roman Ring, Tom Hennigan, Saffron Huang, Loren Maggiore, Chris Jones, Albin Cassirer, Andy Brock, Michela Paganini, Geoffrey Irving, Oriol Vinyals, Simon Osindero, Karen Simonyan, Jack W. Rae, Erich Elsen, Laurent Sifre · 2022 · arXiv:2112.04426v3
打开官方来源分块交叉注意力的结构与训练设置见 RETRO 论文。