扩散与反向采样 前向过程逐步加噪;反向生成从高斯噪声出发,使用训练得到的条件分布逐步采样。 设数据样本为 x 0 ∼ q d a t a x_0\sim q_{\mathrm{data}} x 0 ∼ q data
q ( x t ∣ x t − 1 ) = N ( x t ; α t x t − 1 , β t I ) , α t = 1 − β t , q(x_t\mid x_{t-1})
=\mathcal N\!\left(
x_t;\sqrt{\alpha_t}x_{t-1},\beta_t I
\right),
\qquad \alpha_t=1-\beta_t, q ( x t ∣ x t − 1 ) = N ( x t ; α t x t − 1 , β t I ) , α t = 1 − β t , 其中 0 < β t < 1 0<\beta_t<1 0 < β t < 1
x t = α t x t − 1 + β t ϵ t , ϵ t ∼ N ( 0 , I ) . x_t=\sqrt{\alpha_t}x_{t-1}+\sqrt{\beta_t}\epsilon_t,
\qquad \epsilon_t\sim\mathcal N(0,I). x t = α t x t − 1 + β t ϵ t , ϵ t ∼ N ( 0 , I ) . 每一步缩小已有信号并加入独立高斯噪声。若调度使累计信号接近零,末端 x T x_T x T T T T
输入尺度属于模型定义。图像若从整数区间映射到某个连续范围,训练和采样结束后的逆变换必须一致;超出范围的输出如何裁剪或量化也会影响评价。
令
α ˉ t = ∏ s = 1 t α s . \bar\alpha_t=\prod_{s=1}^{t}\alpha_s. α ˉ t = s = 1 ∏ t α s . 逐步代入并利用独立高斯线性组合仍为高斯,可得
q ( x t ∣ x 0 ) = N ( x t ; α ˉ t x 0 , ( 1 − α ˉ t ) I ) , q(x_t\mid x_0)
=\mathcal N\!\left(
x_t;\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)I
\right), q ( x t ∣ x 0 ) = N ( x t ; α ˉ t x 0 , ( 1 − α ˉ t ) I ) , 因此训练时可直接采样
x t = α ˉ t x 0 + 1 − α ˉ t ϵ , ϵ ∼ N ( 0 , I ) . x_t=\sqrt{\bar\alpha_t}x_0
+\sqrt{1-\bar\alpha_t}\epsilon,\qquad
\epsilon\sim\mathcal N(0,I). x t = α ˉ t x 0 + 1 − α ˉ t ϵ , ϵ ∼ N ( 0 , I ) . 这避免为了得到随机 x t x_t x t t t t
例 1:两步加噪合并为一个高斯
取 β 1 = 0.2 , β 2 = 0.3 \beta_1=0.2,\beta_2=0.3 β 1 = 0.2 , β 2 = 0.3 α 1 = 0.8 , α 2 = 0.7 \alpha_1=0.8,\alpha_2=0.7 α 1 = 0.8 , α 2 = 0.7 α ˉ 2 = 0.56 \bar\alpha_2=0.56 α ˉ 2 = 0.56
x 1 = 0.8 x 0 + 0.2 ϵ 1 , x 2 = 0.7 x 1 + 0.3 ϵ 2 . x_1=\sqrt{0.8}x_0+\sqrt{0.2}\epsilon_1,
\qquad
x_2=\sqrt{0.7}x_1+\sqrt{0.3}\epsilon_2. x 1 = 0.8 x 0 + 0.2 ϵ 1 , x 2 = 0.7 x 1 + 0.3 ϵ 2 . 代入后,x 0 x_0 x 0 0.7 × 0.8 = 0.56 \sqrt{0.7\times0.8}=\sqrt{0.56} 0.7 × 0.8 = 0.56 0.7 × 0.2 + 0.3 = 0.44 = 1 − 0.56 0.7\times0.2+0.3=0.44=1-0.56 0.7 × 0.2 + 0.3 = 0.44 = 1 − 0.56
x 2 = 0.56 x 0 + 0.44 ϵ x_2=\sqrt{0.56}x_0+\sqrt{0.44}\epsilon x 2 = 0.56 x 0 + 0.44 ϵ 在分布上成立,其中 ϵ \epsilon ϵ ϵ 1 + ϵ 2 \epsilon_1+\epsilon_2 ϵ 1 + ϵ 2
给定 x 0 x_0 x 0
q ( x t − 1 ∣ x t , x 0 ) = N ( x t − 1 ; μ ~ t ( x t , x 0 ) , β ~ t I ) , q(x_{t-1}\mid x_t,x_0)
=\mathcal N(x_{t-1};\tilde\mu_t(x_t,x_0),\tilde\beta_t I), q ( x t − 1 ∣ x t , x 0 ) = N ( x t − 1 ; μ ~ t ( x t , x 0 ) , β ~ t I ) , 其中
β ~ t = 1 − α ˉ t − 1 1 − α ˉ t β t , \tilde\beta_t
=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\beta_t, β ~ t = 1 − α ˉ t 1 − α ˉ t − 1 β t , μ ~ t = α ˉ t − 1 β t 1 − α ˉ t x 0 + α t ( 1 − α ˉ t − 1 ) 1 − α ˉ t x t . \tilde\mu_t
=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}x_0
+\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}x_t. μ ~ t = 1 − α ˉ t α ˉ t − 1 β t x 0 + 1 − α ˉ t α t ( 1 − α ˉ t − 1 ) x t . 生成时未知 x 0 x_0 x 0
p θ ( x t − 1 ∣ x t ) = N ( x t − 1 ; μ θ ( x t , t ) , Σ θ ( x t , t ) ) . p_\theta(x_{t-1}\mid x_t)
=\mathcal N\!\left(x_{t-1};\mu_\theta(x_t,t),\Sigma_\theta(x_t,t)\right). p θ ( x t − 1 ∣ x t ) = N ( x t − 1 ; μ θ ( x t , t ) , Σ θ ( x t , t ) ) . 均值和方差可按不同参数化学习或固定。公式必须与实现采用的方差、时间索引和边界步一致,不能把一种采样器的系数直接移入另一种。
网络接收 x t x_t x t ϵ θ ( x t , t ) \epsilon_\theta(x_t,t) ϵ θ ( x t , t )
x ^ 0 = x t − 1 − α ˉ t ϵ θ ( x t , t ) α ˉ t . \hat x_0
=\frac{x_t-\sqrt{1-\bar\alpha_t}\epsilon_\theta(x_t,t)}
{\sqrt{\bar\alpha_t}}. x ^ 0 = α ˉ t x t − 1 − α ˉ t ϵ θ ( x t , t ) . 把它代入后验均值并整理,得到常用形式
μ θ ( x t , t ) = 1 α t ( x t − β t 1 − α ˉ t ϵ θ ( x t , t ) ) . \mu_\theta(x_t,t)
=\frac{1}{\sqrt{\alpha_t}}
\left(
x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}
\epsilon_\theta(x_t,t)
\right). μ θ ( x t , t ) = α t 1 ( x t − 1 − α ˉ t β t ϵ θ ( x t , t ) ) . 训练常从数据、时间步和标准高斯采样,最小化
L s i m p l e = E x 0 , t , ϵ ∥ ϵ − ϵ θ ( x t , t ) ∥ 2 2 . \mathcal L_{\mathrm{simple}}
=\mathbb E_{x_0,t,\epsilon}
\left\lVert
\epsilon-\epsilon_\theta(x_t,t)
\right\rVert_2^2. L simple = E x 0 , t , ϵ ∥ ϵ − ϵ θ ( x t , t ) ∥ 2 2 . 这个简化目标与变分训练各时间项有密切关系,但省略或改变了某些权重;不能把未加限定的均方误差直接称为完整精确似然最大化。
一次可复现更新依次执行:从数据集取得并规范化 x 0 x_0 x 0 t t t ϵ \epsilon ϵ ϵ \epsilon ϵ x t x_t x t x t x_t x t
损失归约也需明确。常见做法先对每个样本的空间与通道求平均,再按时间权重和批量平均;若直接把所有元素求和,分辨率和批量会改变梯度尺度。时间步若非均匀采样,要把采样概率与目标权重一起考虑,否则训练目标被悄然改写。记录各时间区间的样本数、均方误差和预测范数,可发现模型只在部分信噪比工作。
时间索引是常见边界错误。代码可能用零到 T − 1 T-1 T − 1 T T T β t \beta_t β t α ˉ t \bar\alpha_t α ˉ t x 0 , t , ϵ x_0,t,\epsilon x 0 , t , ϵ x t x_t x t x ^ 0 \hat x_0 x ^ 0 μ θ \mu_\theta μ θ
若训练保存当前权重和指数滑动平均权重,采样时使用哪一份必须写入模型版本。两份权重产生不同生成分布,不能在评价中混用。噪声预测、x 0 x_0 x 0
例 2:一维前向加噪与反推均值
继续使用 α 1 = 0.8 , α 2 = 0.7 , α ˉ 2 = 0.56 \alpha_1=0.8,\alpha_2=0.7,\bar\alpha_2=0.56 α 1 = 0.8 , α 2 = 0.7 , α ˉ 2 = 0.56 x 0 = 2 x_0=2 x 0 = 2 ϵ = 0.5 \epsilon=0.5 ϵ = 0.5
x 2 = 0.56 × 2 + 0.44 × 0.5 ≈ 1.828. x_2=\sqrt{0.56}\times2+\sqrt{0.44}\times0.5
\approx1.828. x 2 = 0.56 × 2 + 0.44 × 0.5 ≈ 1.828. 若网络预测 ϵ θ = 0.4 \epsilon_\theta=0.4 ϵ θ = 0.4
μ θ = 1 0.7 ( 1.828 − 0.3 0.44 × 0.4 ) ≈ 1.969. \mu_\theta
=\frac1{\sqrt{0.7}}
\left(1.828-\frac{0.3}{\sqrt{0.44}}\times0.4\right)
\approx1.969. μ θ = 0.7 1 ( 1.828 − 0.44 0.3 × 0.4 ) ≈ 1.969. 若网络恰好预测真实噪声 0.5 0.5 0.5 1.915 1.915 1.915
μ ~ 2 = 0.8 × 0.3 0.44 × 2 + 0.7 × 0.2 0.44 × 1.828 ≈ 1.915. \tilde\mu_2
=\frac{\sqrt{0.8}\times0.3}{0.44}\times2
+\frac{\sqrt{0.7}\times0.2}{0.44}\times1.828
\approx1.915. μ ~ 2 = 0.44 0.8 × 0.3 × 2 + 0.44 0.7 × 0.2 × 1.828 ≈ 1.915. 这验证了噪声参数化与后验均值的一致性。预测误差会改变每一步均值,并可能在长反向链中累积。
噪声预测与得分的关系
对固定 x 0 x_0 x 0
∇ x t log q ( x t ∣ x 0 ) = − x t − α ˉ t x 0 1 − α ˉ t = − ϵ 1 − α ˉ t . \nabla_{x_t}\log q(x_t\mid x_0)
=-\frac{x_t-\sqrt{\bar\alpha_t}x_0}{1-\bar\alpha_t}
=-\frac{\epsilon}{\sqrt{1-\bar\alpha_t}}. ∇ x t log q ( x t ∣ x 0 ) = − 1 − α ˉ t x t − α ˉ t x 0 = − 1 − α ˉ t ϵ . 在均方误差下,最优噪声预测是给定 x t x_t x t
s θ ( x t , t ) ≈ − ϵ θ ( x t , t ) 1 − α ˉ t . s_\theta(x_t,t)
\approx-\frac{\epsilon_\theta(x_t,t)}
{\sqrt{1-\bar\alpha_t}}. s θ ( x t , t ) ≈ − 1 − α ˉ t ϵ θ ( x t , t ) . 这里的得分是对噪声样本坐标的对数密度梯度,不是样本“好坏分数”。有限网络、训练误差和离散时间都会使近似不完美。
例 3:手算条件高斯得分
取 α ˉ t = 0.25 \bar\alpha_t=0.25 α ˉ t = 0.25 x 0 = 2 x_0=2 x 0 = 2 x t = 1.5 x_t=1.5 x t = 1.5 0.25 × 2 = 1 \sqrt{0.25}\times2=1 0.25 × 2 = 1 0.75 0.75 0.75
∇ x t log q ( x t ∣ x 0 ) = − 1.5 − 1 0.75 = − 2 3 . \nabla_{x_t}\log q(x_t\mid x_0)
=-\frac{1.5-1}{0.75}
=-\frac23. ∇ x t log q ( x t ∣ x 0 ) = − 0.75 1.5 − 1 = − 3 2 . 对应标准噪声为 ϵ = ( 1.5 − 1 ) / 0.75 ≈ 0.577 \epsilon=(1.5-1)/\sqrt{0.75}\approx0.577 ϵ = ( 1.5 − 1 ) / 0.75 ≈ 0.577
− ϵ / 0.75 ≈ − 0.577 / 0.866 = − 0.667 , -\epsilon/\sqrt{0.75}\approx-0.577/0.866=-0.667, − ϵ / 0.75 ≈ − 0.577/0.866 = − 0.667 , 与直接结果一致。时间越接近零,1 − α ˉ t 1-\bar\alpha_t 1 − α ˉ t
从高斯先验逐步采样
生成从 x T ∼ N ( 0 , I ) x_T\sim\mathcal N(0,I) x T ∼ N ( 0 , I ) t = T , … , 1 t=T,\ldots,1 t = T , … , 1
x t − 1 = μ θ ( x t , t ) + σ t z , z ∼ N ( 0 , I ) . x_{t-1}
=\mu_\theta(x_t,t)+\sigma_t z,
\qquad z\sim\mathcal N(0,I). x t − 1 = μ θ ( x t , t ) + σ t z , z ∼ N ( 0 , I ) . 最后一步是否加入噪声、σ t 2 \sigma_t^2 σ t 2
标准离散链每一步都需网络前向,采样成本近似随步数增长。减少到较少时间点需要新的离散化、非马尔可夫更新或数值求解策略;它可能更快,也会改变误差、随机性和样本分布,必须重新评价,不能称为跳过若干步而其他完全不变。
例 4:训练抽时刻与生成走全链的成本差异
设原调度有一千个时间点。一次训练更新可对批中每个 x 0 x_0 x 0 t t t x t x_t x t t t t
按原反向链生成一个批量则需约一千次网络前向。若改用五十次网络调用,调用数变为原来的二十分之一,但每一步跨越的噪声区间更大。应在相同硬件、批量和条件下实测端到端延迟,并检查覆盖、条件一致性和误差切片;调用数比例不是质量或墙钟加速的保证。
β t \beta_t β t x 0 x_0 x 0 x T x_T x T α ˉ t \bar\alpha_t α ˉ t
随机抽时间若均匀,并不表示每个信噪比区间对目标贡献相同。可按理论权重或重要性采样改变训练关注点,但必须连同损失权重记录,否则梯度目标改变。网络的时间编码也需覆盖采样使用的全部时间值;推理若访问训练未定义的连续时间,要明确插值或求解器假设。
潜变量扩散模型 训练阶段学习预测加入潜变量的噪声;条件采样从高斯噪声开始,在潜空间逐步去噪后解码为图像。 Rombach 等,2022;依据算法绘制 条件模型把类别、文字或其他观测 c c c ϵ θ ( x t , t , c ) \epsilon_\theta(x_t,t,c) ϵ θ ( x t , t , c )
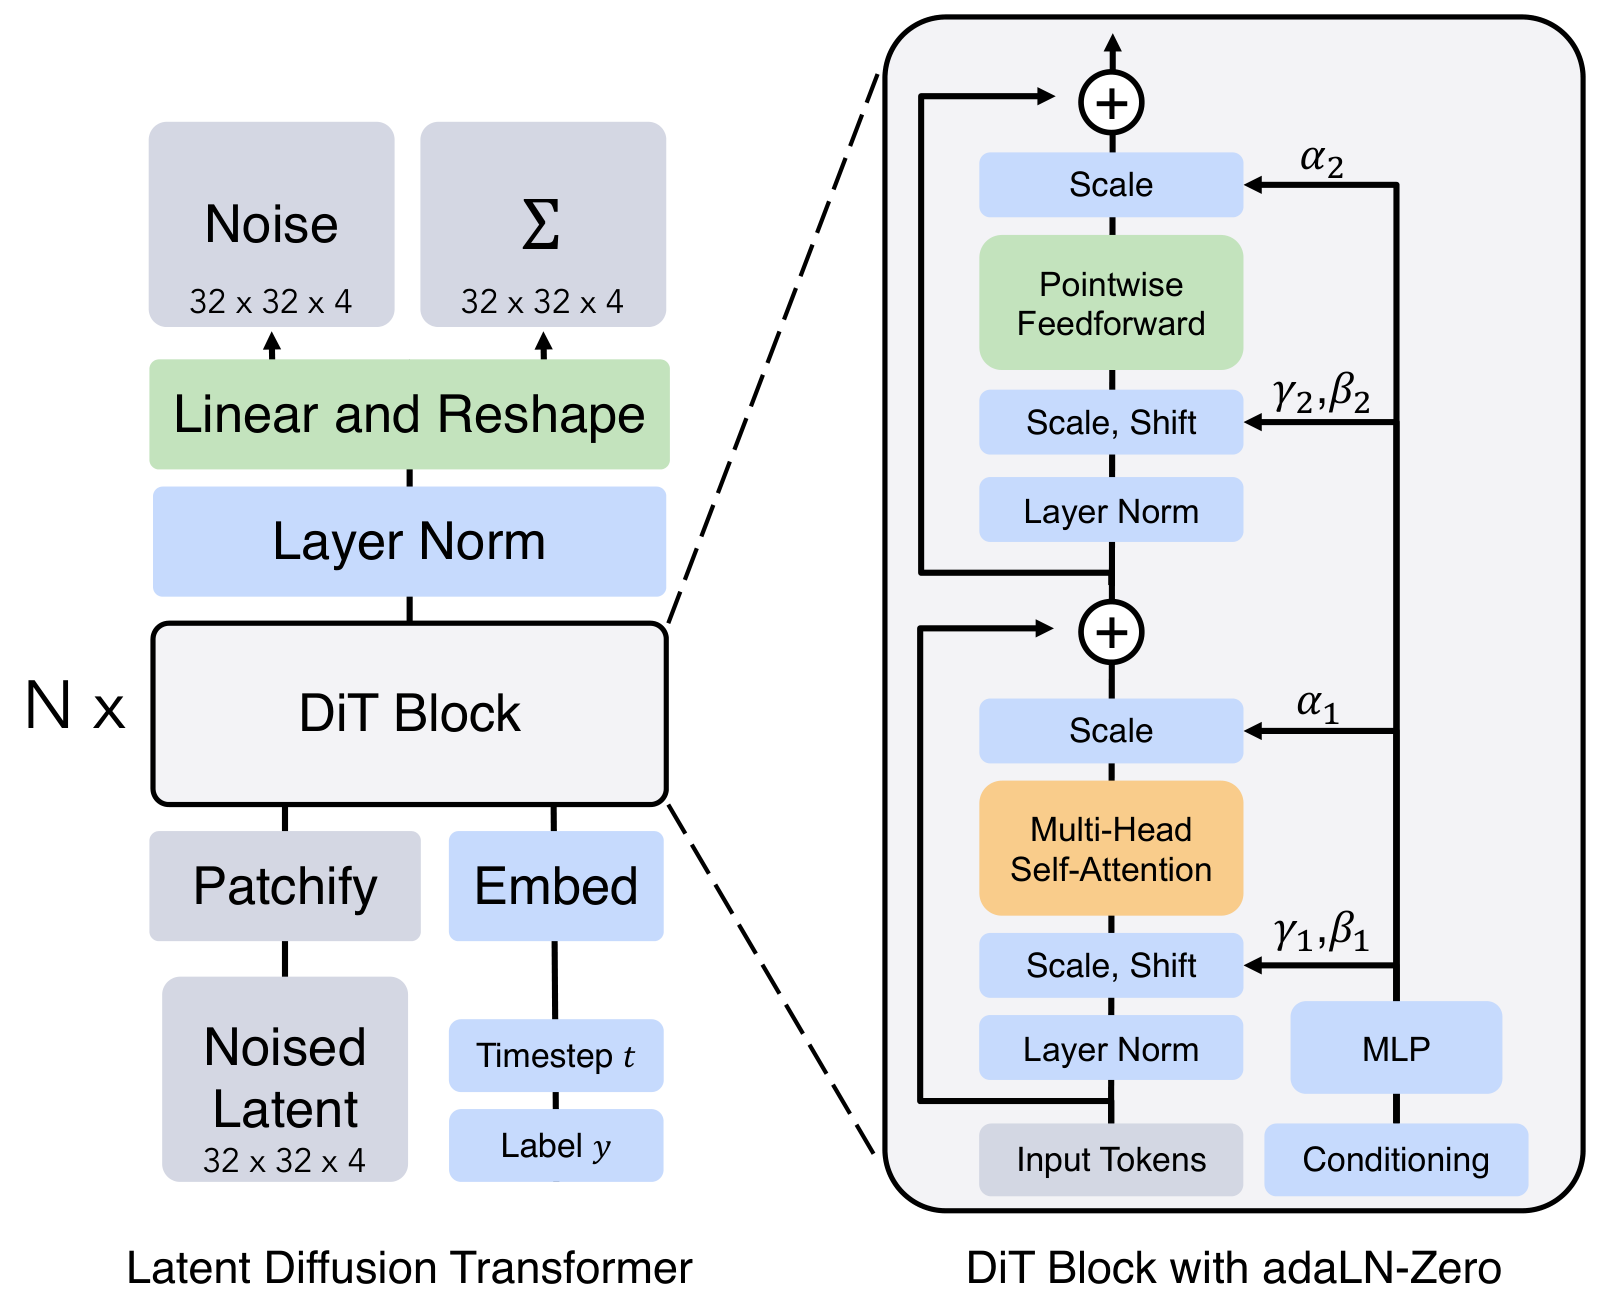
DiT 在潜变量上使用 Transformer 预测噪声与协方差,下图展示其主体结构和 adaLN-Zero 条件模块。
DiT 与条件归一化 带噪潜变量经分块后输入 Transformer;时间和类别嵌入控制各层的缩放、偏移与残差权重。 Peebles 与 Xie,Scalable Diffusion Models with Transformers,ICCV 2023,图 3 局部。裁出主体与 adaLN-Zero 子图。 放大图示 论文原文 CC BY 4.0 一种无外部分类器的写法同时训练有条件和无条件分支。定义引导尺度 γ ≥ 1 \gamma\ge1 γ ≥ 1
ϵ g u i d e = ϵ u n c o n d + γ ( ϵ c o n d − ϵ u n c o n d ) . \epsilon_{\mathrm{guide}}
=\epsilon_{\mathrm{uncond}}
+\gamma\left(
\epsilon_{\mathrm{cond}}-\epsilon_{\mathrm{uncond}}
\right). ϵ guide = ϵ uncond + γ ( ϵ cond − ϵ uncond ) . γ = 1 \gamma=1 γ = 1
例 5:一维无分类器引导
某一步无条件噪声预测为 0.6 0.6 0.6 0.2 0.2 0.2 γ = 1 \gamma=1 γ = 1 0.6 + 1 ( 0.2 − 0.6 ) = 0.2 0.6+1(0.2-0.6)=0.2 0.6 + 1 ( 0.2 − 0.6 ) = 0.2 γ = 2 \gamma=2 γ = 2 0.6 + 2 ( 0.2 − 0.6 ) = − 0.2 0.6+2(0.2-0.6)=-0.2 0.6 + 2 ( 0.2 − 0.6 ) = − 0.2
把这个值代入反向均值会更强地沿条件方向更新。若条件错误或训练配对有偏差,外推也会放大错误。应扫描引导尺度,同时报告条件符合度、多样性、失败样本和推理成本。
扩散概率模型可从变分界分析数据负对数似然,也可使用简化噪声损失训练。报告似然时要说明数据离散化、界还是估计、单位和预处理;不同表示下的数值不能直接比较。较好的界不自动产生更符合人类偏好的样本,反之亦然。
样本评价至少分为视觉或领域质量、分布覆盖、条件一致性、记忆与隐私、鲁棒性和成本。特征空间距离依赖所选特征提取器及参考集,可能忽略领域关键差异;少量精美样本不能排除模式遗漏;随机样本也不能证明没有训练样本复现。应使用固定种子批量、最近训练样本检查、按类别或属性覆盖、领域约束和盲化人工协议共同评价。
生成样本外观逼真不等于它来自真实世界,也不等于内容事实正确。用于科学、医学或历史场景时,必须与真实观测、来源和领域验证分开标识。
练习
练习 1:累计噪声
所属知识 前向扩散
难度 3/5 计算两步调度下 q ( x 2 ∣ x 0 ) q(x_2\mid x_0) q ( x 2 ∣ x 0 )
查看提示 先计算各步alpha再相乘,均值系数取累计值平方根。
查看解答 若beta一为0.1、beta二为0.2,则alpha为0.9和0.8,累计alpha为0.72;条件均值系数为根号0.72,噪声方差为0.28。
练习 2:直接加噪
所属知识 闭式采样
难度 3/5 写出任意时间 t t t
查看提示 把x零和标准噪声分别乘信号与噪声系数后相加。
查看解答 给定累计alpha、x零和epsilon,按根号累计alpha乘x零加根号一减累计alpha乘epsilon;无需逐步生成中间状态。
练习 3:反向均值
所属知识 噪声参数化
难度 4/5 从预测噪声分别用两条路径计算 μ θ \mu_\theta μ θ
查看提示 先用网络噪声估计x零,再代入后验均值,或使用整理后的等价公式。
查看解答 两条路径在系数和时间索引一致时相同;预测噪声误差通过beta除以噪声标准差进入均值,并会沿反向链累积。
练习 4:得分尺度
所属知识 得分匹配
难度 4/5 查看提示 条件高斯得分是负的残差除以方差,也等于负噪声除以噪声标准差。
查看解答 得分为负的xt减信号均值再除以一减累计alpha;网络噪声需除以根号一减累计alpha并取负,不能直接把epsilon称为得分。
练习 5:减步评价
所属知识 采样调度
难度 5/5 查看提示 调用数减少只描述一项成本,还要核对求解规则、随机性和分布误差。
查看解答 固定模型、硬件、批量和条件,记录调用数、墙钟时间与显存;重新检查样本质量、覆盖、条件一致性和失败切片,不能从步数比例直接推出同倍加速或无损质量。
练习 6:引导与真实性
所属知识 评价边界
难度 5/5 查看提示 扫描引导尺度并把条件符合度、多样性、记忆和事实核验分开。
查看解答 增大引导可外推条件方向,也可能降低多样性并放大偏差;应分别报告条件、覆盖、伪影和最近训练样本,并明确生成外观不证明真实来源或事实。
关系与资源
Denoising Diffusion Probabilistic Models Jonathan Ho, Ajay Jain, Pieter Abbeel · 2020 · Advances in Neural Information Processing Systems 33
打开官方来源 Deep Learning Ian Goodfellow, Yoshua Bengio, Aaron Courville · 2016 · MIT Press
打开官方来源 DDPM 原论文用于核对固定前向加噪链、参数化反向过程、变分界与噪声预测目标;《Deep Learning》用于核对潜变量模型、概率链和梯度优化基础。本章的离散扩散公式以原论文约定为准,连续时间 score 表达被标为后续推广,不由 2020 年论文的离散实验无条件推出。
Scalable Diffusion Models with Transformers William Peebles, Saining Xie · 2023 · IEEE/CVF International Conference on Computer Vision 2023
打开官方来源 High-Resolution Image Synthesis with Latent Diffusion Models Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser, Björn Ommer · 2022 · IEEE/CVF Conference on Computer Vision and Pattern Recognition 2022
打开官方来源 潜空间去噪的 Transformer 与 U-Net 实现分别见这两篇论文。